Как мы поднимали упавшую ноду Proxmox: мёртвый диск, зависший pmxcfs и расколотый кластер
Утро началось с того, что нода proxmox-02 перестала отвечать. Не «медленно работала», не «ругалась в мониторинге», а просто исчезла: нет SSH, нет веб-интерфейса, в кластере — в статусе offline. Диагноз после вскрытия: умер диск, на котором стояла операционная система Proxmox.
Хорошая новость была в том, как эта нода была собрана: все виртуальные машины и контейнеры лежали на отдельных дисках. OPNsense, две ноды Kubernetes (control plane и worker), OpenMediaVault с NFS для кластера, BareOS с бэкапами и медиасервер — всё это осталось физически целым. Умер только системный диск, на котором не было ничего, кроме самой Proxmox.
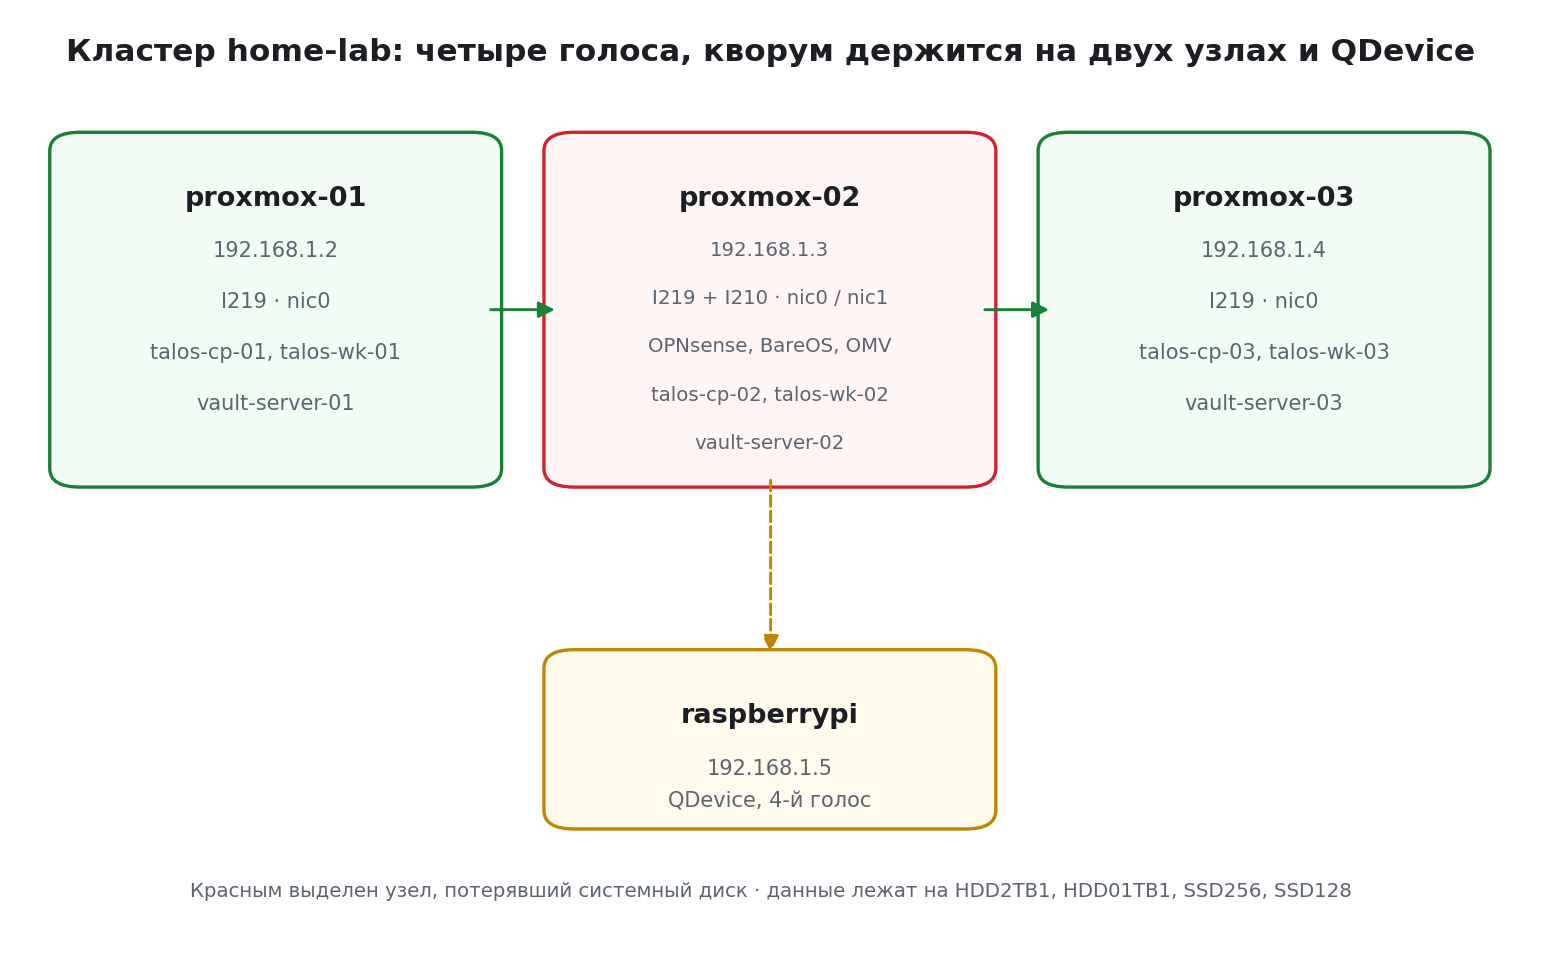
Эта история — про то, как мы за один день прошли путь от «нода мертва» до «кластер в полном составе и все сервисы работают», и по дороге уронили кластер ещё раз, уже своими руками. Оба эпизода стоят того, чтобы их записать.
Что именно потерялось вместе с системным диском
Разделение данных и ОС спасло железо, но не конфигурацию. В Proxmox конфиги виртуальных машин и контейнеров — это файлы в /etc/pve, а /etc/pve — это FUSE-монтирование базы pmxcfs, которая живёт на системном диске. Сгорел диск — уехали и конфиги: сколько памяти, какие диски, какие сети, какой порядок загрузки.
Образы дисков при этом целы. Это значит, что восстановление — не «поднять из бэкапа», а «переустановить ноду, вернуть её в кластер и заново собрать описания машин, которые уже лежат на дисках».
Шаг 1. Подготовка, которая экономит всё остальное
Первое и самое важное действие — физически отключить все диски с данными перед установкой. Установщик Proxmox форматирует выбранный диск без лишних вопросов, и один неверный пункт в списке целей — это потеря 600 гигабайт бэкапов.
Пока нода ещё была в сознании, мы сняли инвентарь:
lsblk -o NAME,SIZE,TYPE,MODEL,SERIAL
lvs; vgs; pvs; zpool list; blkid
cat /etc/pve/storage.cfg
ls /etc/pve/nodes/*/qemu-server/ /etc/pve/nodes/*/lxc/
Шаг 2. Установка: новая нода с тем же именем
Ничего экзотического: Proxmox VE 9.2.2, hostname proxmox-02.geracorp.work, тот же адрес 192.168.1.3/24, корень на ext4 — данные всё равно на других дисках.
Единственный сюрприз — имена сетевых интерфейсов. На старых нодах кластера они назывались eno1 и enp1s0, а свежая установка PVE 9 назвала их nic0 и nic1. Если где-то в автоматизации зашиты старые имена, после переустановки это выстрелит.
Разбираться, кто есть кто, надо не по именам, а по PCI-адресам:
readlink -f /sys/class/net/nic0/device   # 0000:00:1f.6 — I219-V
readlink -f /sys/class/net/nic1/device   # 0000:01:00.0 — I210-T1
lspci | grep -i ethernet
Шаг 3. Сеть: грабли на ровном месте
Нода поднялась, адрес 192.168.1.3 отвечал. Дальше захотелось «навести порядок» в бриджах через веб-интерфейс — и в этот момент нода пропала второй раз.
Причина простая и обидная: адрес жил на бридже vmbr0. Бридж удалили, создали новый vmbr1 — вместе с vmbr0 уехали и адрес, и маршрут по умолчанию. А новый бридж был создан с параметром bridge-ports none, то есть без единого физического порта: конфигурация выглядит рабочей, но L2 у неё нет вообще.
Итог в конфиге после лечения:
auto lo
iface lo inet loopback

iface nic0 inet manual
iface nic1 inet manual

auto vmbr1
iface vmbr1 inet static
	address 192.168.1.3/24
	gateway 192.168.1.1
	bridge-ports nic0
	bridge-stp off
	bridge-fd 0
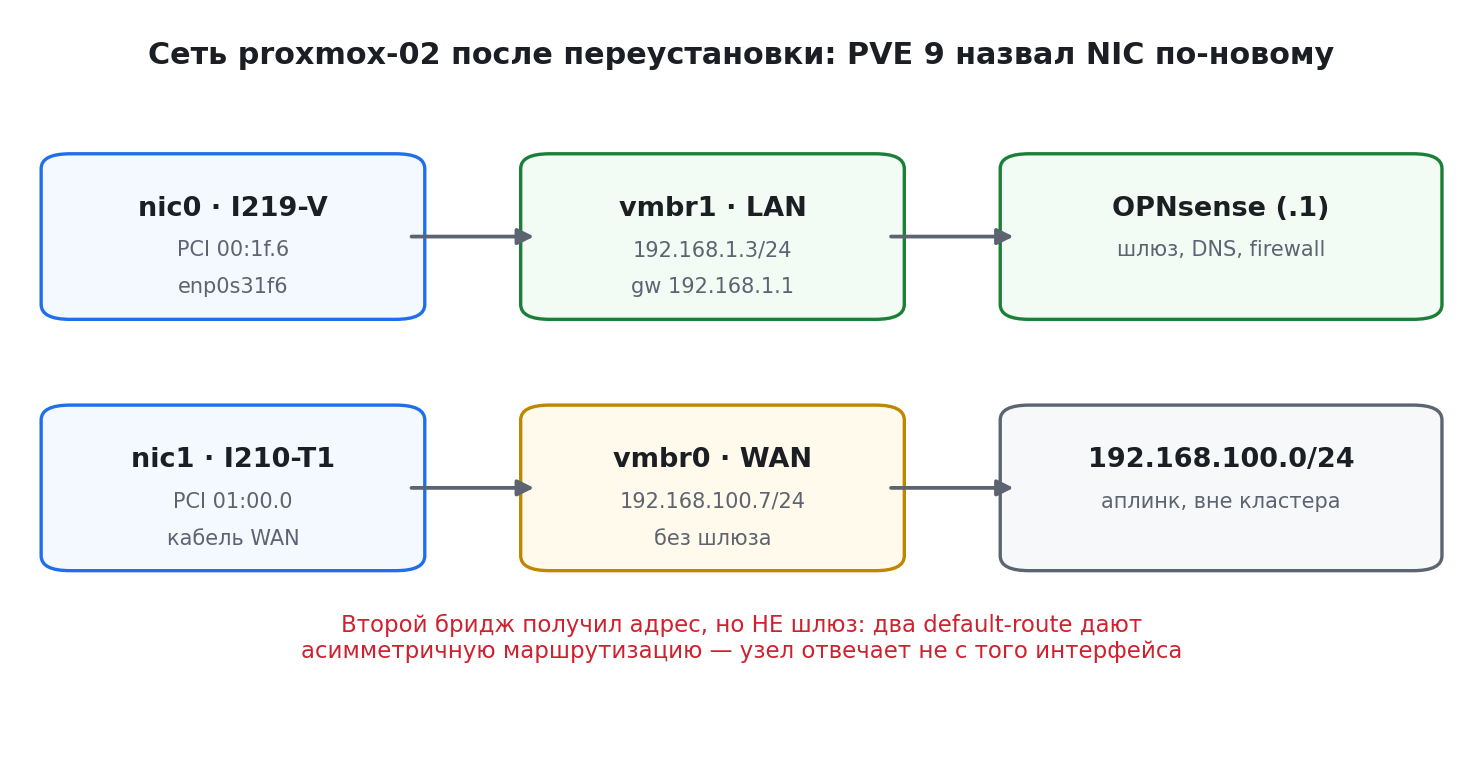
Два правила, которые стоит запомнить:
- Применять сеть только через
ifreload -a(это ifupdown2), а неsystemctl restart networking— второе рвёт соединение жёстче и не даёт применить частичные изменения. - Второму бриджу (
vmbr0, сеть192.168.100.0/24) даём адрес, но не даём шлюз. Два default-route — это классическая асимметричная маршрутизация: пакет приходит с одного интерфейса, а ответ уходит с другого. Именно из-за этого нода когда-то «не пинговалась через туннель», хотя была жива.
Вытащить себя из такой ямы без консоли почти нельзя, поэтому спасательный круг: повесить на физический интерфейс другой временный адрес, зайти по SSH и спокойно править конфиг.
Шаг 4. Данные: диски вернулись сами, а вот VMID пришлось искать
Подключаем диски обратно. ZFS-пулы не поднимаются автоматически — их надо импортировать и прописать кэш, иначе после следующей перезагрузки они снова «пропадут»:
zpool import -f SSD256
zpool import -f HDD01TB1
zpool set cachefile=/etc/zfs/zpool.cache SSD256
zpool set cachefile=/etc/zfs/zpool.cache HDD01TB1
Дальше — самое полезное открытие дня. Конфиги машин мы считали потерянными, но pvecm delnode удаляет ноду из corosync, а каталог /etc/pve/nodes/proxmox-02/ с конфигами остаётся на других нодах кластера. Все девять конфигов — OPNsense, BareOS, OpenMediaVault, talos-cp-02, talos-wk-02, vault-server-02 и три шаблона — нашлись там целиком.
Даже если бы их не было, VMID’ы восстанавливаются из имён томов: vm-112-disk-0 — это машина 112, vm-301-cloudinit — машина 301.
И отдельная ловушка: том с именем vm-115-disk-0 мы сначала приняли за осиротевший диск. Оказалось, это rootfs контейнера 115 (медиасервер на 200 ГБ), и его конфиг был на месте. Проверять надо pct list, а не только qm list.
Шаг 5. Возвращение в кластер
pvecm add proxmox-03.geracorp.work
Два нюанса, на которых легко застрять:
- Только по FQDN, не по IP. При подключении по IP вылезает
hostname verification failed: сертификат ноды выписан на имя, а не на адрес. И/etc/hostsс именами всех нод надо заполнить заранее — DNS в момент аварии обычно тоже лежит. config_versionв/etc/pve/corosync.confдолжен совпадать на всех нодах. Нода, застрявшая на старой версии конфига, не собирает кольцо с остальными, и кластер тихо распадается на две партиции, каждая из которых выглядит «наполовину живой».
Побочная авария: как мы сами положили кластер
Самое интересное началось, когда нода вошла в кластер, но данные так и не синхронизировались, а /etc/pve оказался read-only. Дальше — часы диагностики и один очень полезный вывод.
Симптомы:
touch /etc/pve/fooвиснет навсегда, процесс в состоянииD;qm listвиснет;- посторонние демоны (
cron,pvestatd,pve-firewall) тоже набиваются вD; - в логе
pve-cluster—[dcdb] notice: cpg_send_message retry 40 … retry 60; - при этом чтение из
/etc/pveработает прекрасно.
Причина оказалась в архитектуре pmxcfs. Это однопоточная штука: любая запись идёт через dcdb и рассылается по кластеру через cpg, и каждый такой запрос ждёт подтверждения от всех участников кольца. Один зависший запрос — и pmxcfs залипает целиком. А поскольку dcdb реплицируется, встаёт запись на всех нодах сразу.
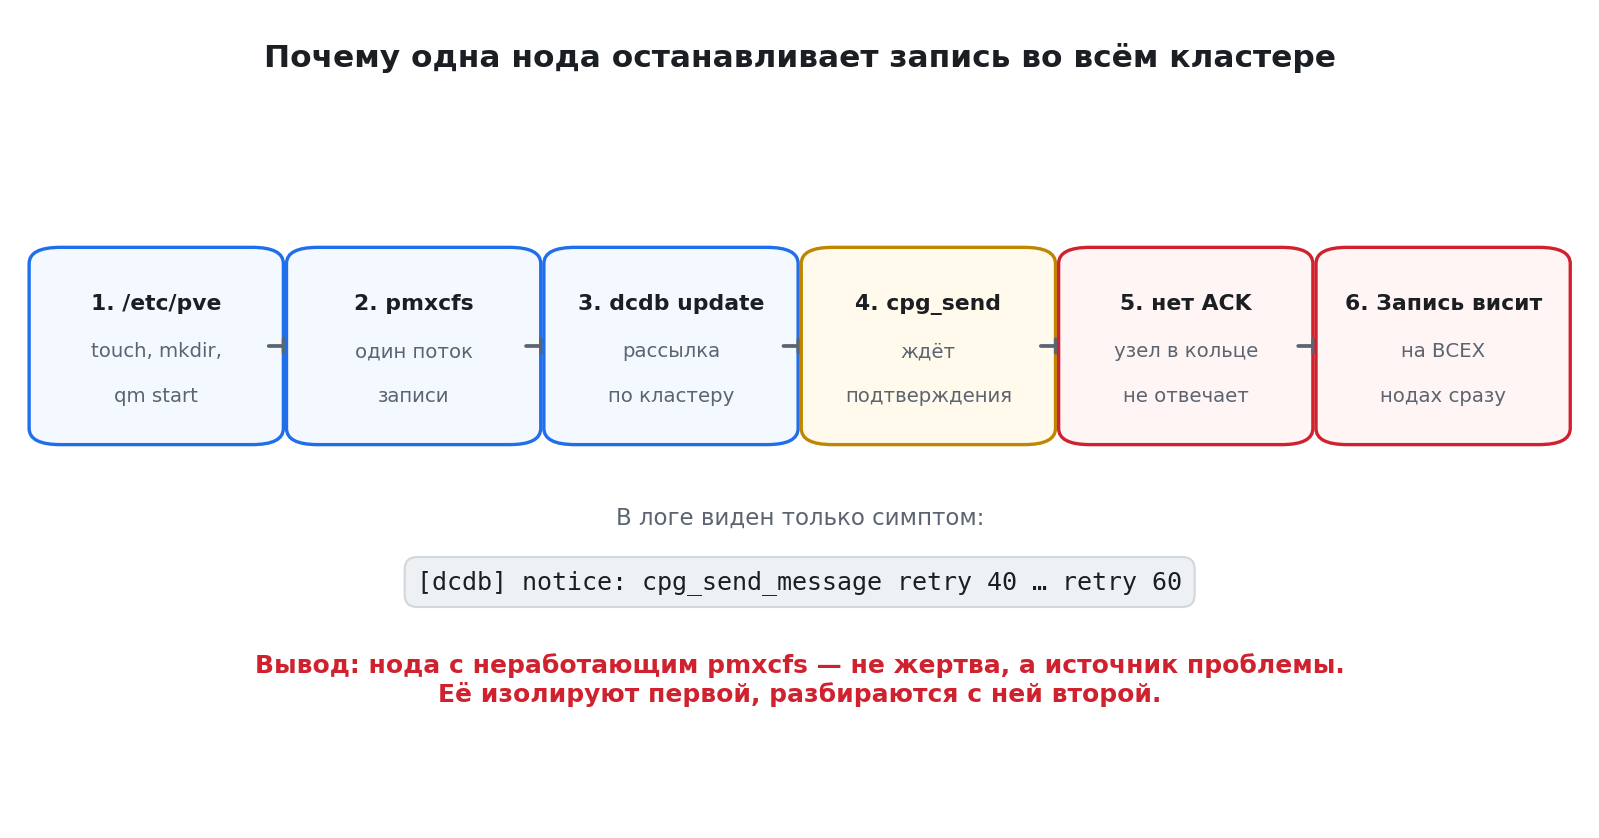
Главный вывод, который стоит записать большими буквами: нода, у которой не пишется /etc/pve, — это не жертва, а источник проблемы. Её изолируют первой (systemctl stop corosync pve-cluster), а разбираются с ней второй. Пока мы этого не сделали, кластер валился от любой попытки что-то поправить.
Лечение заняло три шага. Сначала — FUSE-монтирование зависших запросов в порядок:
for d in /sys/fs/fuse/connections/*; do
  [ "$(cat $d/waiting)" != 0 ] && echo 1 > $d/abort
done
Потом — самое неочевидное: битая база config.db ведёт себя как отказ железа. SMART говорит PASSED, диск в порядке, а клин возвращается после каждой перезагрузки. Поэтому базу надо не «перезагрузить», а пересоздать, а затем отдать её синхронизацию живым нодам:
systemctl stop corosync pve-cluster
cp -a /var/lib/pve-cluster/config.db /root/config.db.bak
rm -f /var/lib/pve-cluster/config.db{,-shm,-wal}

# локальный режим: /etc/pve доступен на запись без кворума
/usr/bin/pmxcfs -l &
# ... вернуть corosync.conf, затем:
pkill -f '^/usr/bin/pmxcfs -l$'; umount /etc/pve
systemctl start pve-cluster corosync
И третье — страховка. Перед возвратом «подозрительной» ноды в кольцо на ней запускается сторож, который раз в десять секунд пробует записать файл в /etc/pve и после трёх провалов подряд сам гасит corosync и pve-cluster. Так одна сломанная нода больше не может утянуть за собой весь кластер.
Шаг 6. Сертификаты: ошибка 596
После переустановки веб-интерфейс начал отдавать error:0A000086:SSL routines::certificate verify failed (596). Это не про браузер: так ругается API-прокси, когда из интерфейса одной ноды обращаешься к другой и сертификат соседа не совпадает с закреплённым отпечатком. Причина — у переустановленной ноды остался сертификат установки с именем вида proxmox-02.home.local.
pvecm updatecerts -f
openssl x509 -in /etc/pve/local/pve-ssl.pem -noout -subject -issuer
openssl verify -CAfile /etc/pve/pve-root-ca.pem /etc/pve/local/pve-ssl.pem
systemctl restart pveproxy pvedaemon
Остальные ноды обновляют список отпечатков сами, при первом же обращении.
Шаг 7. Порядок запуска сервисов
Тут всё решает зависимость. Первой поднимается OPNsense — она и есть шлюз 192.168.1.1, без неё у остальных нет интернета. Дальше — OpenMediaVault, потому что она отдаёт NFS кластеру. Потом control plane, воркеры и Vault.
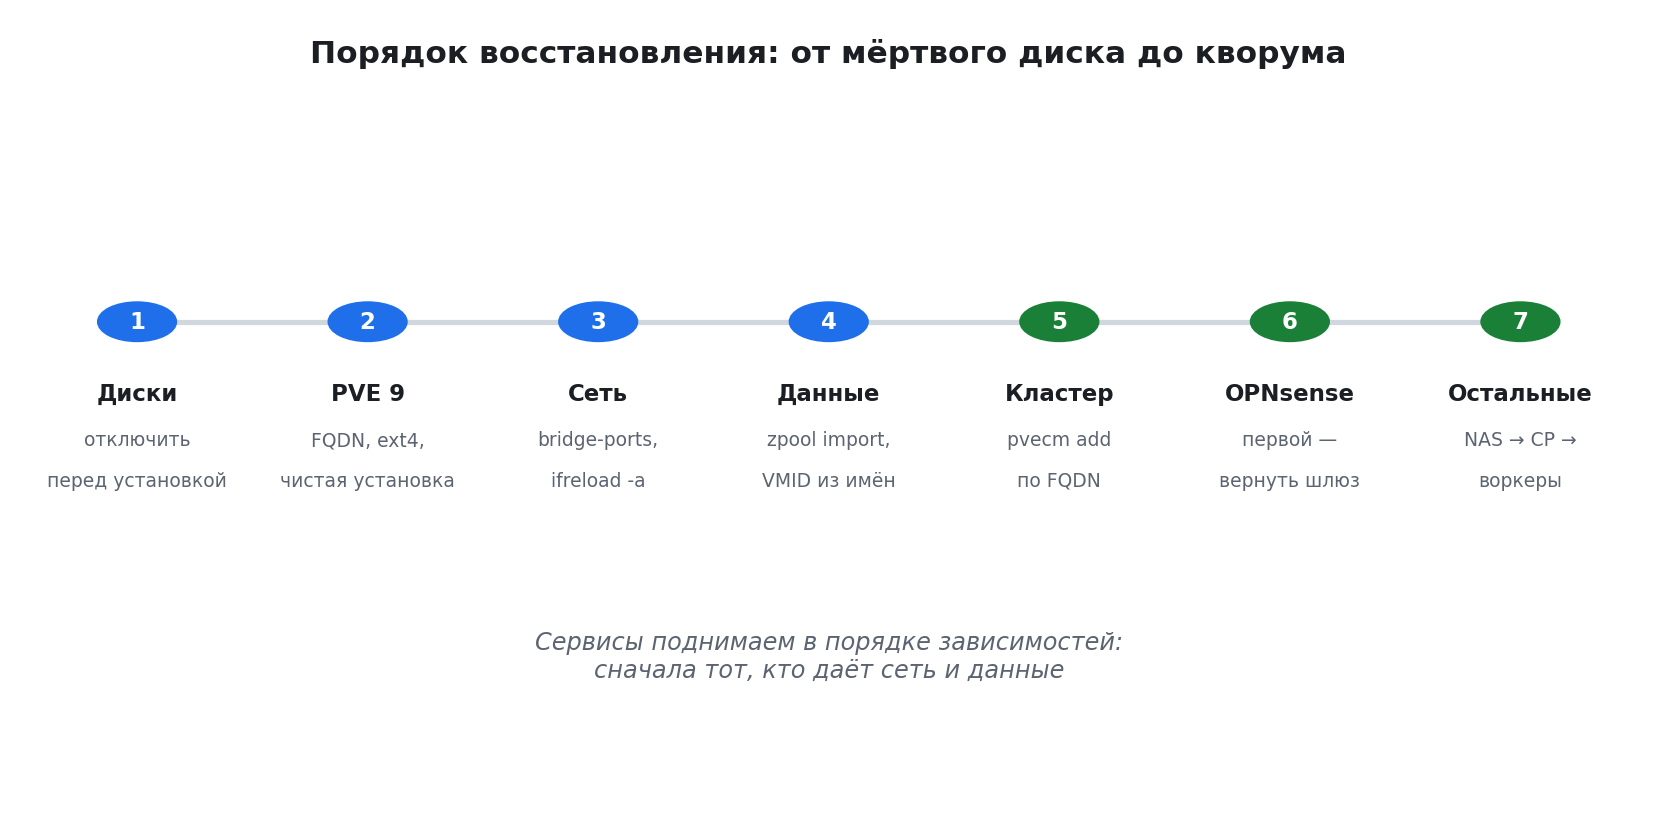
Один нюанс из практики: машина, убитая принудительной перезагрузкой, остаётся с локом в конфиге (lock: backup), и qm start отказывается работать. Снимается одной командой:
qm unlock 112
qm start 112
Чем всё закончилось
| Проверка | Результат |
|---|---|
| Кластер | 4 узла, Quorate: Yes, config_version совпадает |
/etc/pve |
пишется на всех нодах |
| proxmox-02 | 6 VM running, все хранилища active |
| Kubernetes | 3/3 control plane отвечают |
| Vault | 3/3 узла распечатаны, лидер выбран |
| Сеть | все линки 1000 Мбит/с, full duplex |
Отдельно про сеть: ethtool на всех нодах показал гигабит и full duplex, ошибок нет. Оффлоады на Intel I219 (tcp-segmentation, generic-receive) выключены — это тот самый старый фикс против зависаний e1000e, который стоит держать включённым на всех нодах с этими картами.
Что бы сделали иначе
- Не трогать сеть через веб-интерфейс, пока не работает консоль. Удаление бриджа с адресом менеджмента — это гарантированный выезд на площадку.
- Изолировать подозрительную ноду прежде, чем её лечить. Кластерная файловая система синхронная: больная нода заражает всех.
- Держать
/etc/hostsс именами всех нод. В аварию DNS обычно ложится вместе с инфраструктурой. - Прописывать
zpool cachefileсразу после импорта. Иначе пулы тихо не поднимутся после перезагрузки. - Не считать диск осиротевшим, пока не проверил контейнеры.
vm-NNN-disk-0может быть rootfs контейнера, и он прекрасно жив.
Цена урока — один системный диск и полдня работы. Цена альтернативы, если бы на системном диске лежали данные, была бы совсем другой. Если у вас в Proxmox всё ещё «ОС и виртуалки на одном диске» — это, пожалуй, лучший повод разнести их по разным.